# адрес вашей установки вместе с /v1
export HF_ENDPOINT=https://vault.example.com/v1

# токен из раздела «Токены доступа»
export VAULT_TOKEN=amr_R7xK9Qd2LmT4
export HF_TOKEN=$VAULT_TOKEN
Документация
Работа с реестром
Рабочие сценарии: подключить привычные клиенты к своему реестру, забрать модель и датасет, обучить на своем стенде, вернуть результат новой версией и поднять инференс. В примерах используется адрес vault.example.com - замените его на адрес вашей установки.
1. Обзор
AI-Vault - реестр моделей и датасетов внутри контура компании. Он хранит артефакты, ведет версии и владельцев, выдает доступ по ролям и токенам. Обучение и запуск моделей идут вне продукта, на вашей ML-платформе: реестр отвечает за то, откуда веса берутся и куда возвращаются.
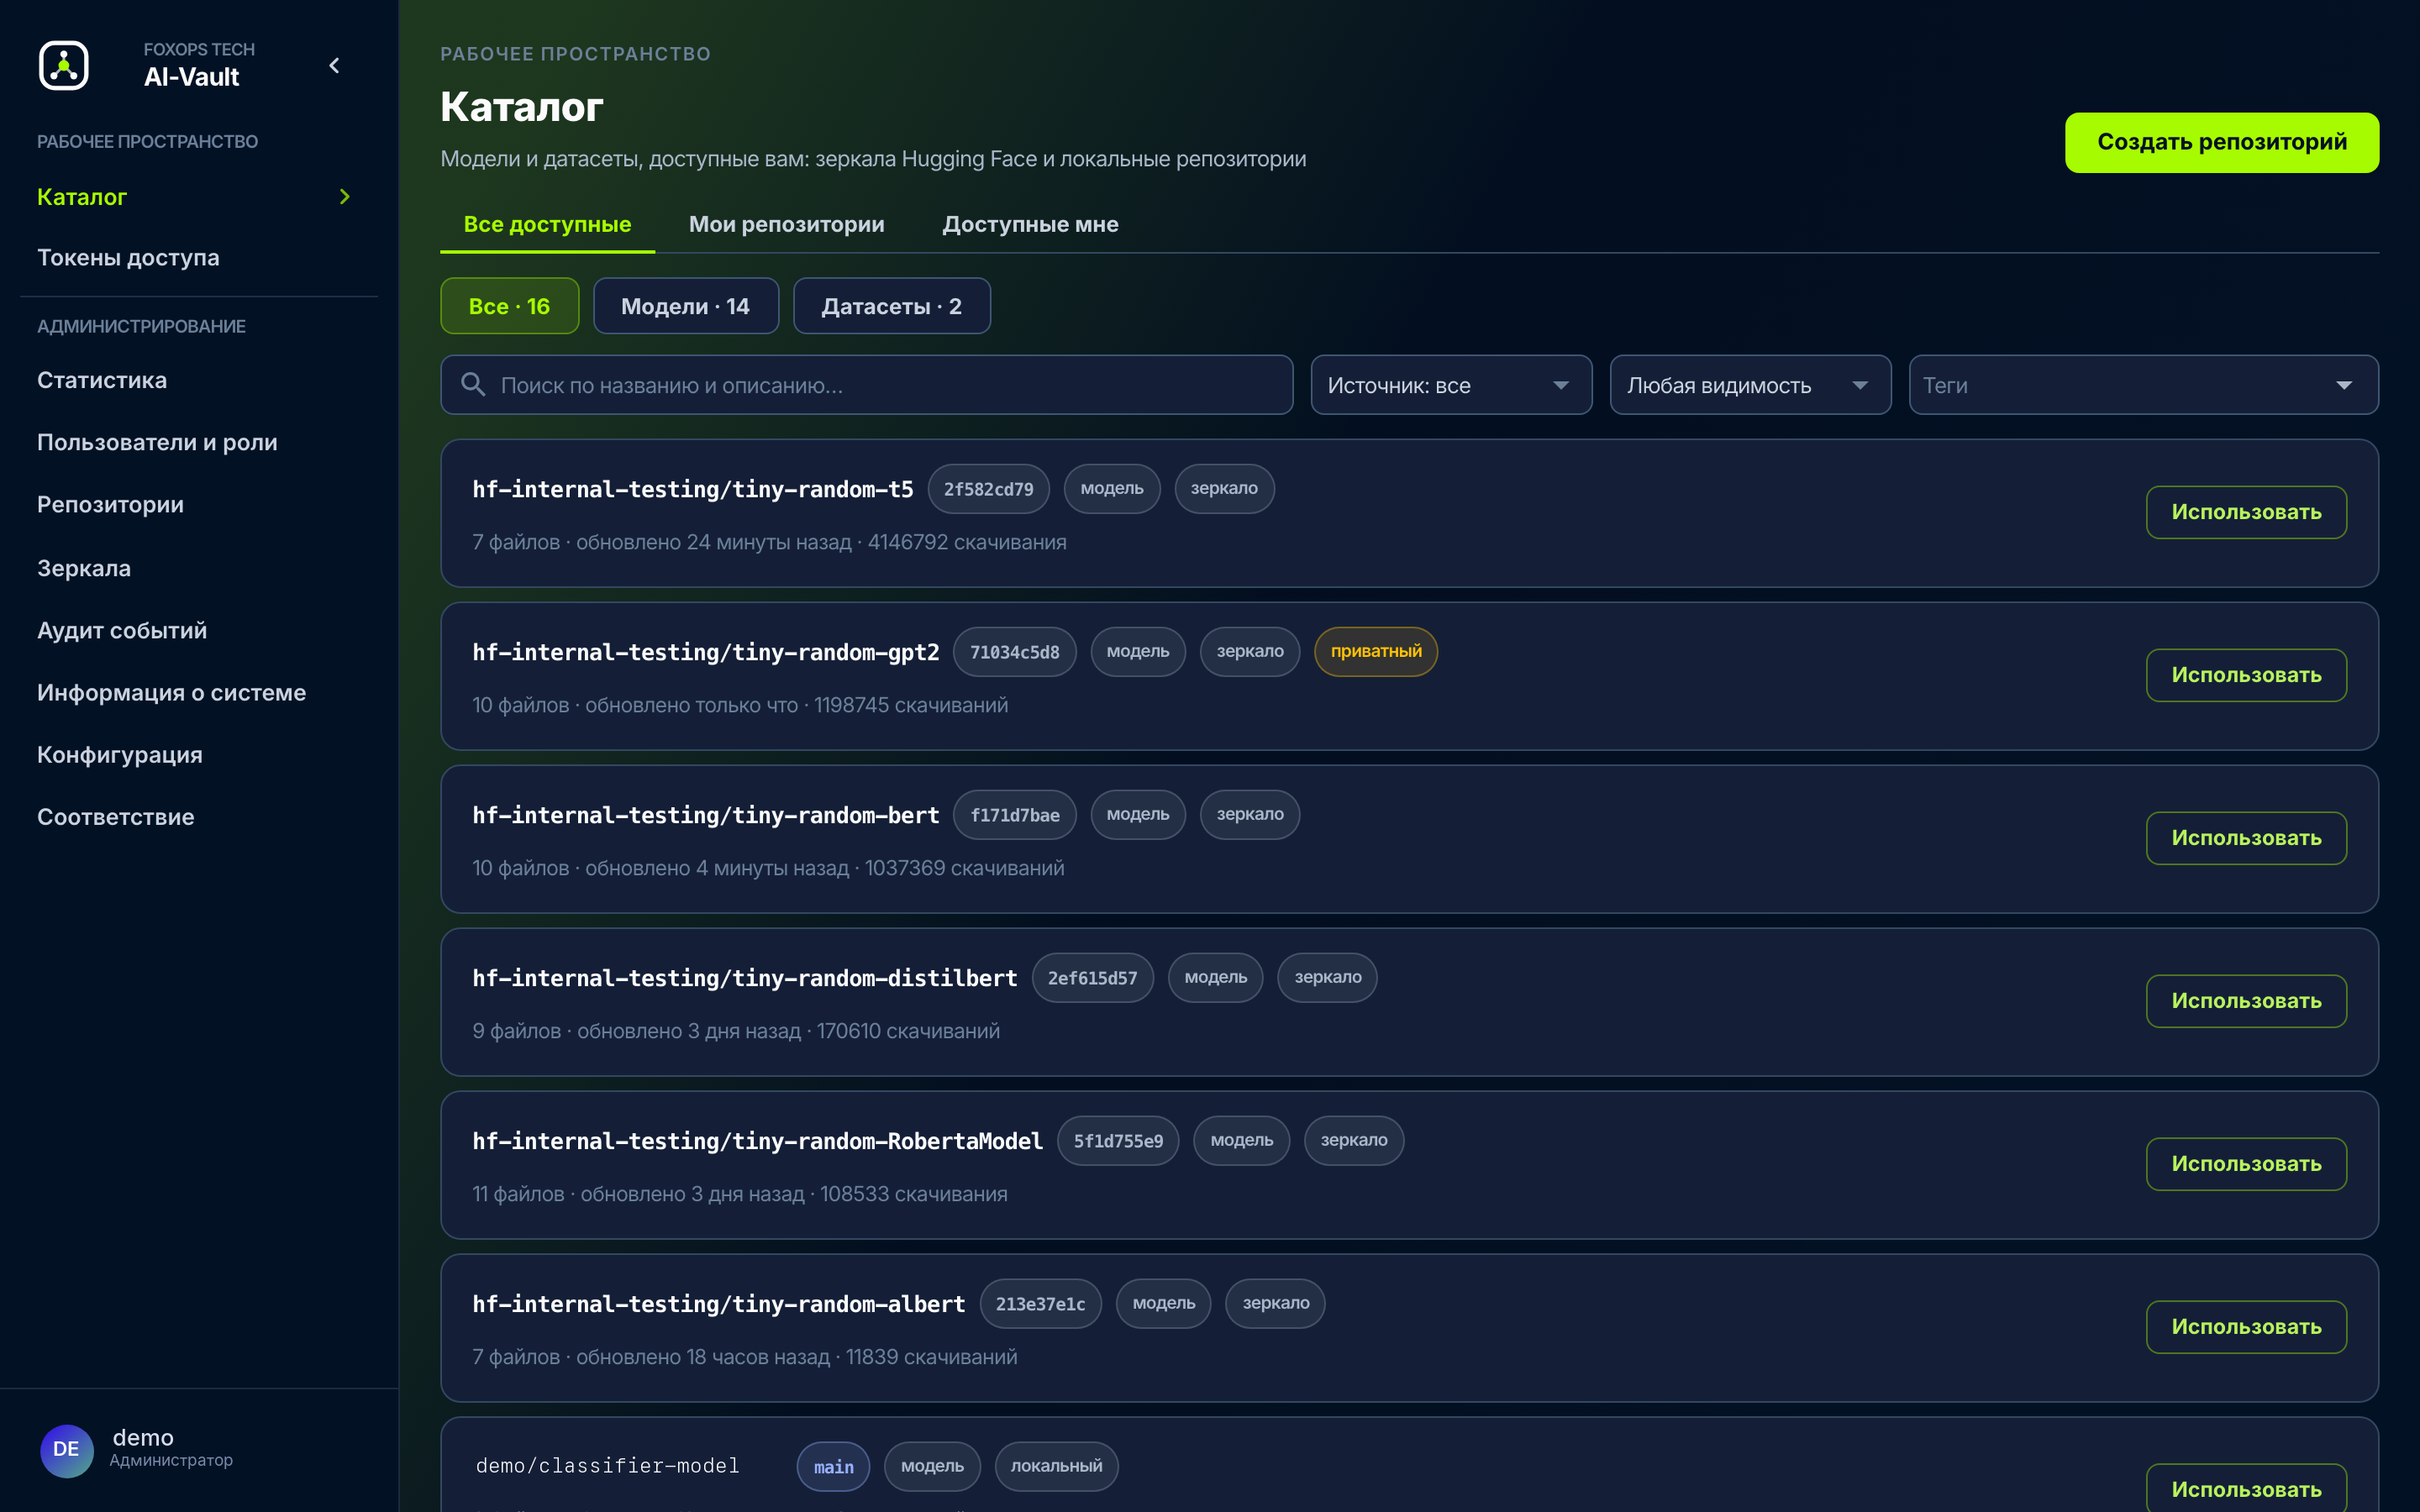
Реестр говорит на протоколе Hugging Face. Значит, transformers, huggingface_hub, huggingface-cli, vLLM и совместимые приложения работают с ним без правок кода - меняется только адрес. Каждый репозиторий одновременно доступен как git-репозиторий: это две двери в одно хранилище, а не две копии.
Что входит в базовую лицензию
Реестр моделей и датасетов, совместимость с Hugging Face, работа через git, права до конкретного репозитория, токены доступа, единый формат карточки и статистика потребления.
Что подключается отдельными модулями
Связь с внешними хабами (зеркалирование), вход через корпоративный каталог (LDAP и OIDC), хранение в S3-совместимом объектном хранилище, журнал событий с фильтрами и выгрузкой. Разделы, которые опираются на модуль, помечены.
2. Подключение к реестру
Настройка делается один раз на рабочей машине или на агенте CI. Дальше все сценарии этого руководства опираются на нее.
Выпустить токен
Раздел «Токены доступа» → «Создать API-ключ». Задаются название, срок действия в днях и набор прав:
| Право | Что разрешает |
|---|---|
IMAGE_PULL | Скачивание артефактов |
IMAGE_PULL_MIRROR | Скачивание из зеркала |
REPO_CREATE_OWN | Создание собственных репозиториев |
REPO_PUSH | Публикация файлов и коммитов |
REPO_ACCESS_GRANT | Управление доступами |
Если не отмечено ничего, токен получает полные права вашей роли. Значение показывается один раз после создания - скопируйте сразу. Для разового CI-задания есть обмен: «Обменять токен» выпускает короткоживущий токен с теми же правами на срок от 1 до 1440 минут.
Переключить клиенты на свой адрес
HF_ENDPOINT - стандартная переменная клиентов Hugging Face. Обратите внимание на суффикс /v1: адрес инстанса указывается вместе с ним.
bash
Проверка: если адрес и токен приняты, вернется список файлов репозитория.
python
import os
os.environ["HF_ENDPOINT"] = "https://vault.example.com/v1"

from huggingface_hub import HfApi

api = HfApi(token=os.environ["HF_TOKEN"])
print(api.list_repo_files("Ultralytics/YOLO26"))
['README.md', 'config.json', 'yolo26n.pt', 'yolo26s.pt', 'yolo26m.pt']
Больше в коде ничего не меняется: from_pretrained, snapshot_download, hf_hub_download и загрузка датасетов остаются прежними. Так же подключаются huggingface-cli, LangGraph, Langflow и Ollama. Готовый сниппет под ваш клиент есть в самом реестре - вкладка «Примеры использования» в карточке репозитория.
Токен действует ровно в тех правах, с которыми выпущен: с одним
IMAGE_PULL публикация вернет 403. Не используйте один токен для ноутбука и для CI - отзыв одного не должен ломать второе.3. Скачать готовую модель
Задача: взять готовый детектор как основу для своей работы. В примерах - Ultralytics/YOLO26.
python
from huggingface_hub import snapshot_download, hf_hub_download

# весь репозиторий
local_path = snapshot_download("Ultralytics/YOLO26", repo_type="model")

# либо один файл весов конкретной версии
weights = hf_hub_download(
    "Ultralytics/YOLO26",
    filename="yolo26n.pt",
    revision="main",          # можно указать тег версии
    local_dir="./weights",
)
print(weights)
./weights/yolo26n.pt
Тот же файл забирается обычным curl. Флаг -C - продолжает прерванную загрузку с места обрыва - на тонком канале это основной рабочий режим.
bash
curl -L -C - -H "Authorization: Bearer $VAULT_TOKEN" \
  -o yolo26n.pt \
  https://vault.example.com/v1/models/Ultralytics/YOLO26/resolve/main/yolo26n.pt

sha256sum yolo26n.pt
  % Total    % Received   Time    Speed
100 5241k   100 5241k   0:00:03  1520k/s

8f3c1a7e94b25d06e1c8ab5f7d2390c4e6b81af0d5c7429e3b6a10f8d47c2e59  yolo26n.pt
У каждой версии хранится контрольная сумма. Сравните ее со значением в карточке версии: совпадение означает, что файл не подменили и не повредили при передаче.
Веса на диске - загрузите их по локальному пути. Обращений наружу при этом нет.
python
from ultralytics import YOLO

model = YOLO("./weights/yolo26n.pt")
results = model.predict("samples/frame_0001.jpg", conf=0.25)

for r in results:
    print(r.boxes.cls, r.boxes.conf)
Закрепляйте в пайплайне тег версии, а не
main: тогда обновление модели в реестре не поменяет поведение вашего кода молча.4. Датасет и обучение
Полный цикл: забрать датасет из реестра, обучить на своем стенде, вернуть результат новой версией. Датасет здесь - внутренние данные компании, они лежат в вашем же реестре: cv-team/fingerprints.
python
from huggingface_hub import snapshot_download

data = snapshot_download(
    "cv-team/fingerprints",
    repo_type="dataset",
    local_dir="./data/fingerprints",
)
Обучение идет на вашем оборудовании - AI-Vault модели не обучает и не запускает. Реестр в этом шаге не участвует.
python
from ultralytics import YOLO

model = YOLO("./weights/yolo26n.pt")          # базовые веса из раздела 3
model.train(data="./data/fingerprints/data.yaml", epochs=50, imgsz=640)
Epoch    GPU_mem   box_loss   cls_loss   Instances
 50/50     6.71G      0.412      0.283          128
              Class     Images  Instances    mAP50   mAP50-95
                all        420       1174    0.947      0.731

Results saved to runs/detect/train
Готовые веса возвращаются в реестр новой версией. Токену нужны права REPO_CREATE_OWN (если репозитория еще нет) и REPO_PUSH.
python
from huggingface_hub import HfApi

api = HfApi(token=os.environ["HF_TOKEN"])
repo = "cv-team/fingerprint-detector"

api.create_repo(repo, repo_type="model", exist_ok=True)
api.upload_file(
    path_or_fileobj="runs/detect/train/weights/best.pt",
    path_in_repo="model.pt",
    repo_id=repo,
    commit_message="v1.1.0: дообучение на данных Q2",
)
api.create_tag(repo, tag="v1.1.0")
model.pt: 100%|██████████| 22.4M/22.4M [00:02<00:00, 9.31MB/s]
https://vault.example.com/v1/models/cv-team/fingerprint-detector/tree/main
Коллеге, чтобы взять именно эту версию, менять ничего не нужно - только назвать тег:
python
weights = hf_hub_download("cv-team/fingerprint-detector", "model.pt", revision="v1.1.0")
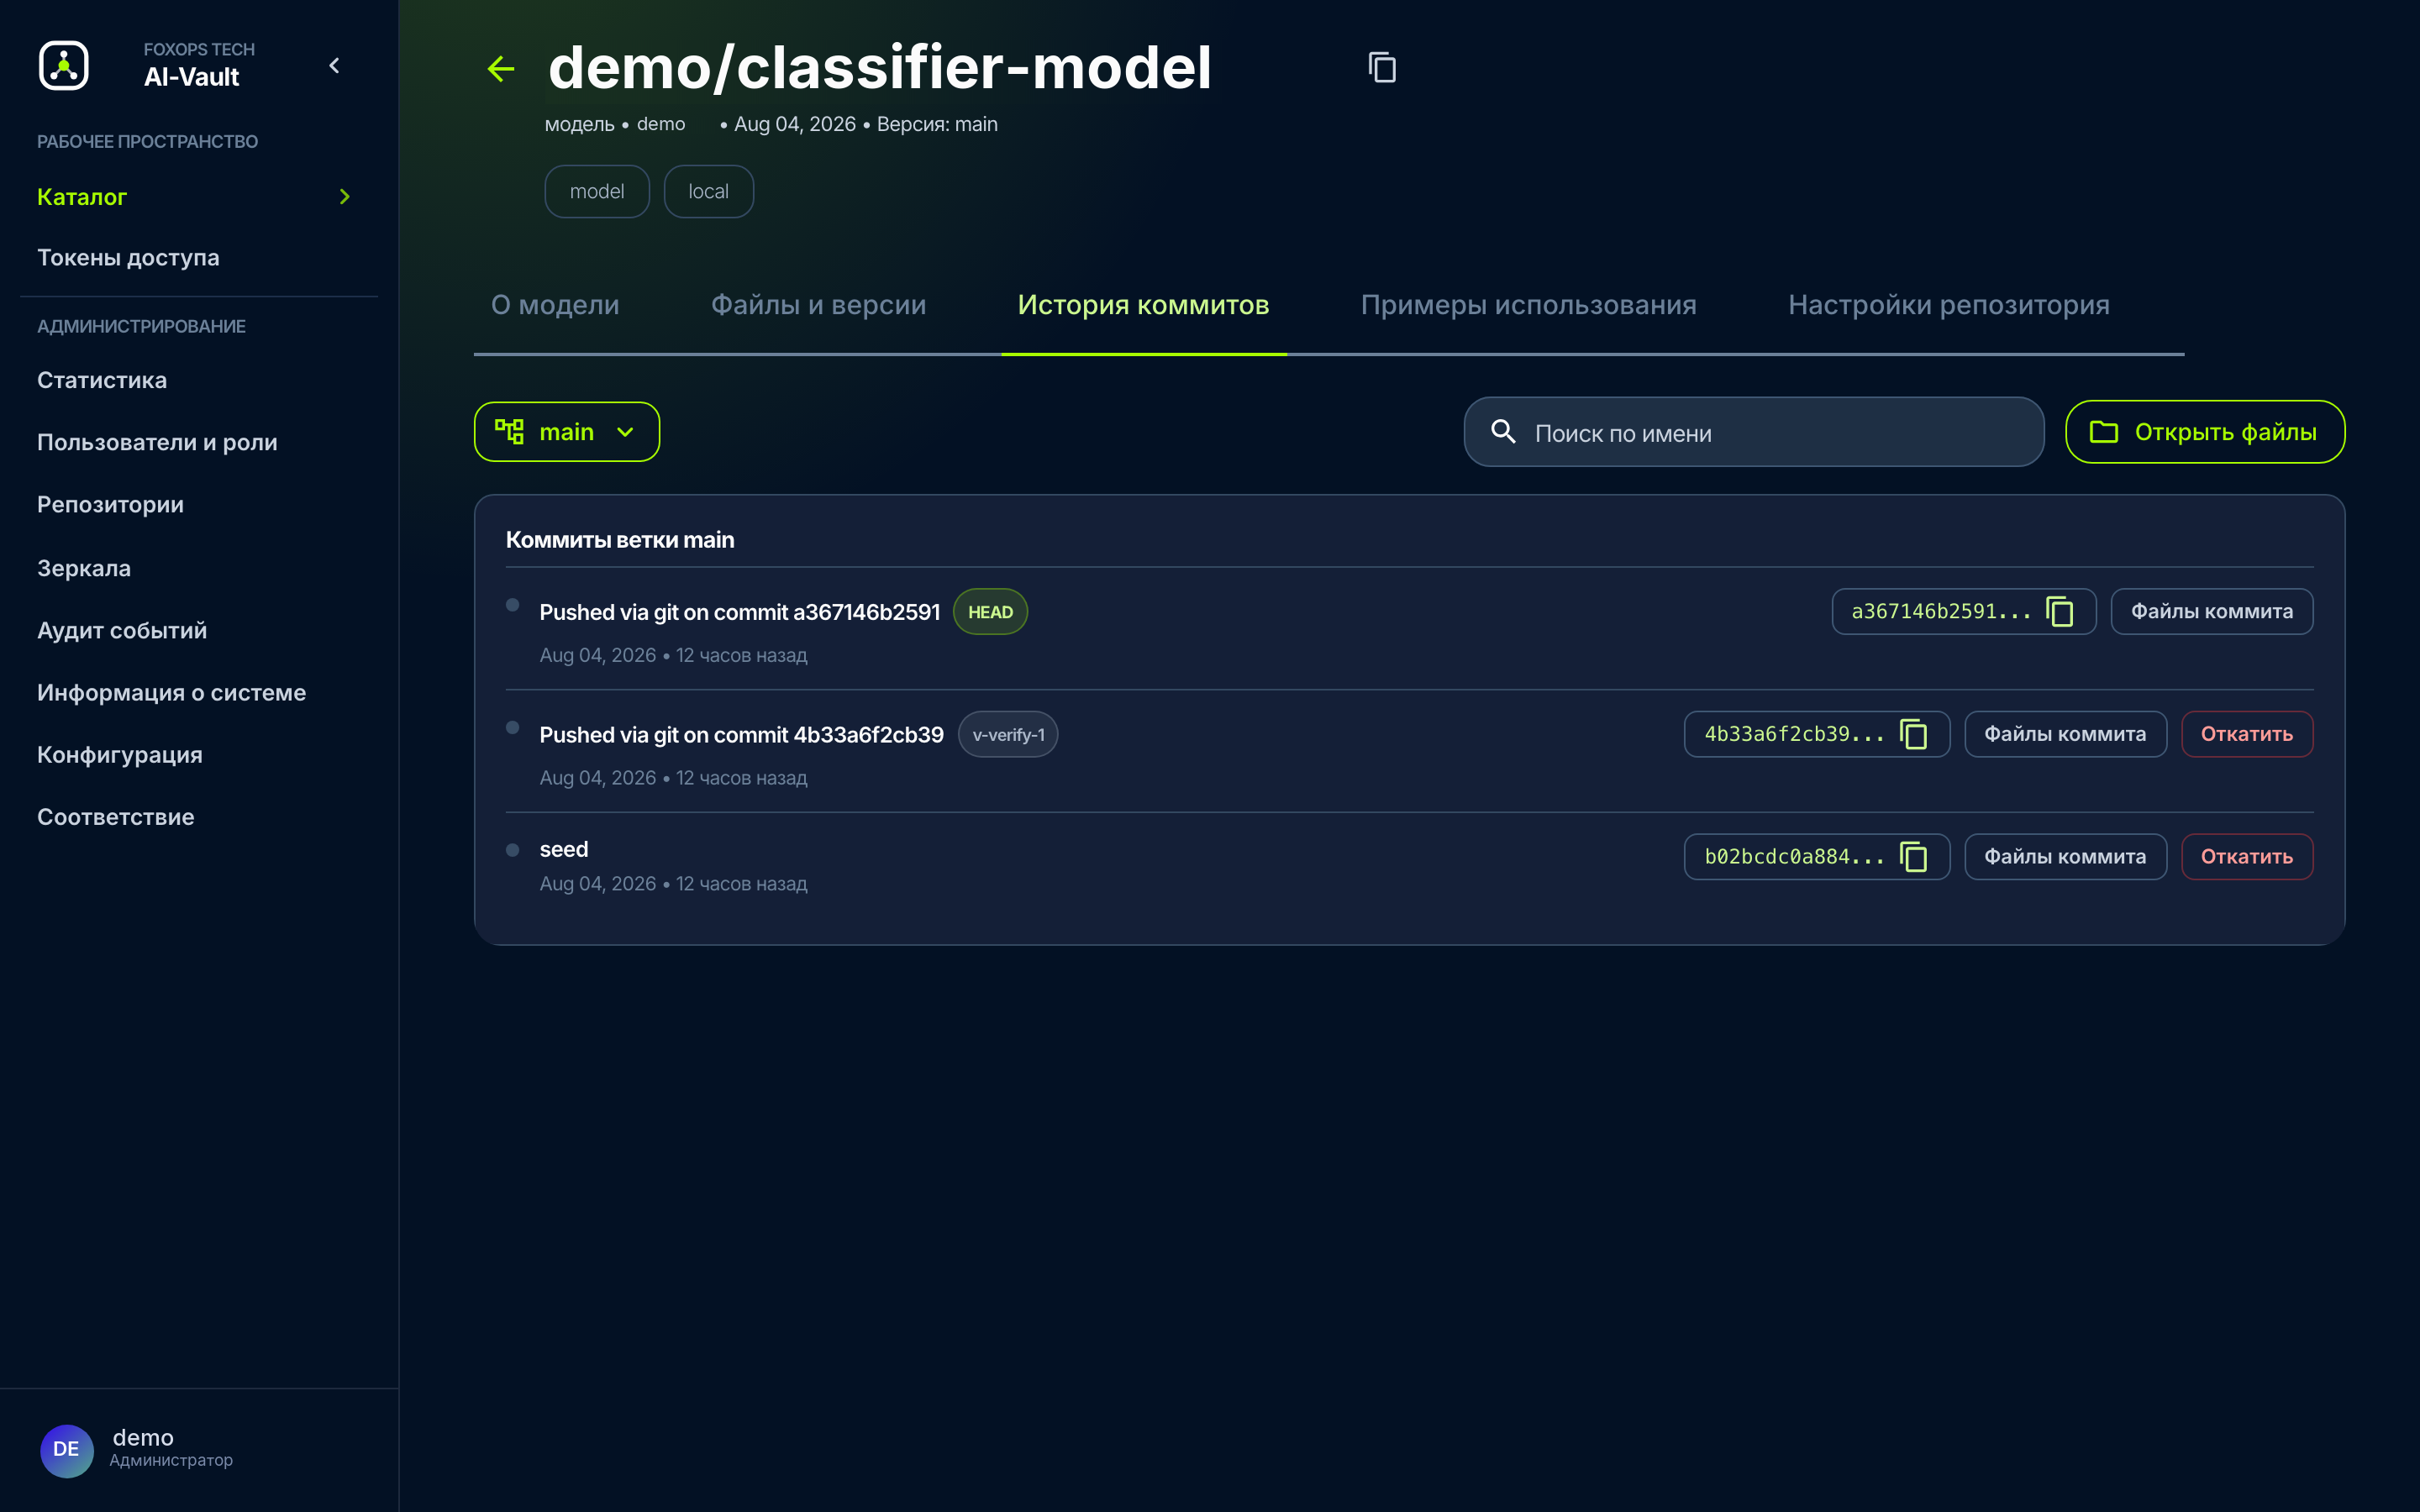
Если новая версия окажется хуже прежней, откат делается в карточке репозитория: вкладка «История коммитов» → «Откатить» у нужного коммита. Предыдущие версии никуда не исчезают.
5. Дообучение ruBERT
Тот же цикл для текстовой задачи: классификация обращений на базе ai-forever/ruBert-base. Модель и датасет берутся из реестра, обучение идет у вас, результат возвращается новым репозиторием.
python
import os
os.environ["HF_ENDPOINT"] = "https://vault.example.com/v1"

from datasets import load_dataset
from transformers import AutoTokenizer, AutoModelForSequenceClassification

# обычный вызов transformers - адрес уже переключен
tok = AutoTokenizer.from_pretrained("ai-forever/ruBert-base")
model = AutoModelForSequenceClassification.from_pretrained(
    "ai-forever/ruBert-base", num_labels=6,
)

ds = load_dataset("nlp-support/tickets")
python
from transformers import Trainer, TrainingArguments

def prep(batch):
    return tok(batch["text"], truncation=True, max_length=256)

ds = ds.map(prep, batched=True)

trainer = Trainer(
    model=model,
    args=TrainingArguments("out", num_train_epochs=3, per_device_train_batch_size=16),
    train_dataset=ds["train"],
    eval_dataset=ds["validation"],
)
trainer.train()
{'loss': 0.412, 'epoch': 1.0}
{'loss': 0.188, 'epoch': 2.0}
{'loss': 0.121, 'epoch': 3.0}
{'eval_accuracy': 0.934, 'eval_f1': 0.928}
Публикация результата - привычный push_to_hub, он уходит в ваш реестр, а не наружу:
python
model.push_to_hub("nlp-support/rubert-tickets")
tok.push_to_hub("nlp-support/rubert-tickets")
Другая команда подключает модель по имени - тем же кодом, которым пользовалась бы с публичным хабом:
python
clf = AutoModelForSequenceClassification.from_pretrained("nlp-support/rubert-tickets")
6. Запуск в vLLM
vLLM скачивает веса через huggingface_hub, поэтому отдельный интегратор не нужен: тех же двух переменных окружения достаточно, чтобы он тянул модели из вашего реестра, а не из интернета. В примерах - модель nlp-support/assistant-7b, лежащая в вашем контуре.
bash
export HF_ENDPOINT=https://vault.example.com/v1
export HF_TOKEN=$VAULT_TOKEN

# кэш весов держите на быстром диске рядом с GPU
export HF_HOME=/var/lib/vllm/hf

vllm serve nlp-support/assistant-7b
INFO  Starting vLLM API server on http://0.0.0.0:8000
INFO  Resolving nlp-support/assistant-7b from https://vault.example.com/v1
INFO  Loading weights took 34.2 s
INFO  Route: /v1/chat/completions, Methods: POST
Последняя версия, тег или коммит
Какую версию поднимать, задает флаг --revision: он принимает имя ветки, имя тега или идентификатор коммита. Без него берется версия по умолчанию - текущее состояние main.
bash
# последняя версия ветки main
vllm serve nlp-support/assistant-7b

# закрепленный тег - так и надо делать в проде
vllm serve nlp-support/assistant-7b --revision v1.4.0

# конкретный коммит: версия не сдвинется никогда
vllm serve nlp-support/assistant-7b --revision a367146b2591

# токенизатор можно закрепить отдельно, а веса сложить в свой каталог
vllm serve nlp-support/assistant-7b \
  --revision v1.4.0 \
  --tokenizer-revision v1.4.0 \
  --download-dir /var/lib/vllm/models \
  --served-model-name assistant
Проверка, что поднялось именно то, что нужно. Имя в ответе - это --served-model-name, если он задан, иначе идентификатор репозитория:
bash
curl -s http://localhost:8000/v1/models | jq '.data[].id'
"assistant"
В docker-compose то же самое задается переменными окружения. Токен передавайте из хранилища секретов, а не строкой в репозитории:
yaml
services:
  vllm:
    image: vllm/vllm-openai:latest
    command: >
      --model nlp-support/assistant-7b
      --revision v1.4.0
      --served-model-name assistant
    environment:
      HF_ENDPOINT: https://vault.example.com/v1
      HF_TOKEN: ${VAULT_TOKEN}
      HF_HOME: /cache
    volumes:
      - vllm-cache:/cache
    ports:
      - "8000:8000"

volumes:
  vllm-cache:
В проде закрепляйте
--revision тегом или коммитом. Иначе перезапуск пода после публикации новой версии молча поднимет другие веса, а инференс перечитывает модель только при старте - расхождение обнаружится не сразу.7. Работа через git
Каждый репозиторий реестра доступен по Git Smart HTTP. Большие веса передаются через Git LFS, поэтому обычный git clone забирает и метаданные, и файлы модели.
bash
git lfs install
git clone https://vault.example.com/v1/git/cv-team/fingerprint-detector.git
cd fingerprint-detector

git add model.pt
git commit -m "v1.2.0: добавлены ночные снимки"
git tag v1.2.0
git push origin main --tags
Uploading LFS objects: 100% (1/1), 22 MB | 8.4 MB/s, done.
To https://vault.example.com/v1/git/cv-team/fingerprint-detector.git
   4b33a6f..a367146  main -> main
 * [new tag]         v1.2.0 -> v1.2.0
Аутентификация - токен вместо пароля, имя пользователя любое. Права на push проверяются по вашей роли в этом пространстве. Ветки, теги и история работают так, как инженеры уже привыкли, а тот же артефакт остается доступен и по протоколу Hugging Face.
Не подставляйте токен прямо в URL: он осядет в
.git/config и в истории команд. Используйте helper для учетных данных и держите файл с правами 600.8. Зеркалированиемодуль
Раздел описывает связь с внешними хабами. Модуль не входит в базовую лицензию и оплачивается отдельно.
Зеркалирование наполняет реестр моделями из внешнего источника, чтобы команды забирали их изнутри контура. Наружу смотрит только узел зеркалирования - потребители, метаданные и артефакты остаются внутри.
Источник
Раздел «Зеркала» → «Добавить зеркало» → источник upstream:
| Поле | Значение |
|---|---|
| Ключ источника | huggingface - короткий идентификатор в логах и правилах |
| Base URL | https://huggingface.co - адрес файлов |
| API Base URL | https://huggingface.co/api - адрес API |
| Сервисный токен | Необязателен, нужен для приватных репозиториев источника |
| Приоритет | Меньше - проверяется раньше |
| Разрешенные префиксы | Ultralytics/*, ai-forever/* - через запятую; пусто - любые репозитории |
Режимы источника задаются флажками: включен ли источник, использовать ли его по умолчанию для репозиториев, не подошедших ни под один префикс, разрешать ли запрос под токеном пользователя и разрешать ли анонимный доступ к публичным репозиториям.
Два режима наполнения
Прокси. Первый запрос идет наружу через разрешенный шлюз, дальше файлы отдаются локально из кэша. Подходит, когда заранее неизвестно, что понадобится.
Зеркало. Выбранные репозитории копируются целиком по расписанию. После прохода внешний доступ не нужен вовсе - контур работает автономно.
Список зеркал показывает состояние синхронизации, расписание и занятое место. Каждая синхронизация записывает источник, размер, контрольную сумму и инициатора.
Фильтры по этим событиям и выгрузка во внешнюю систему сбора логов - это модуль журнала событий, он подключается отдельно от зеркалирования.
9. Доступ и токены
Права выдаются на конкретный репозиторий, а не на все хранилище. Роли назначаются пользователям и группам; машинные интеграции ходят по токенам с ограниченным набором прав и сроком жизни.
| Роль | Права |
|---|---|
reader | Скачивание, git clone |
publisher | Публикация файлов, git push, создание версий |
owner-admin | Роли и квоты внутри своего пространства |
platform-admin | Глобальные настройки, хранилище, зеркала |
Статистика потребления показывает скачивания, трафик и занятое место в разрезе пользователей и команд - по ней разносятся расходы и планируется емкость.
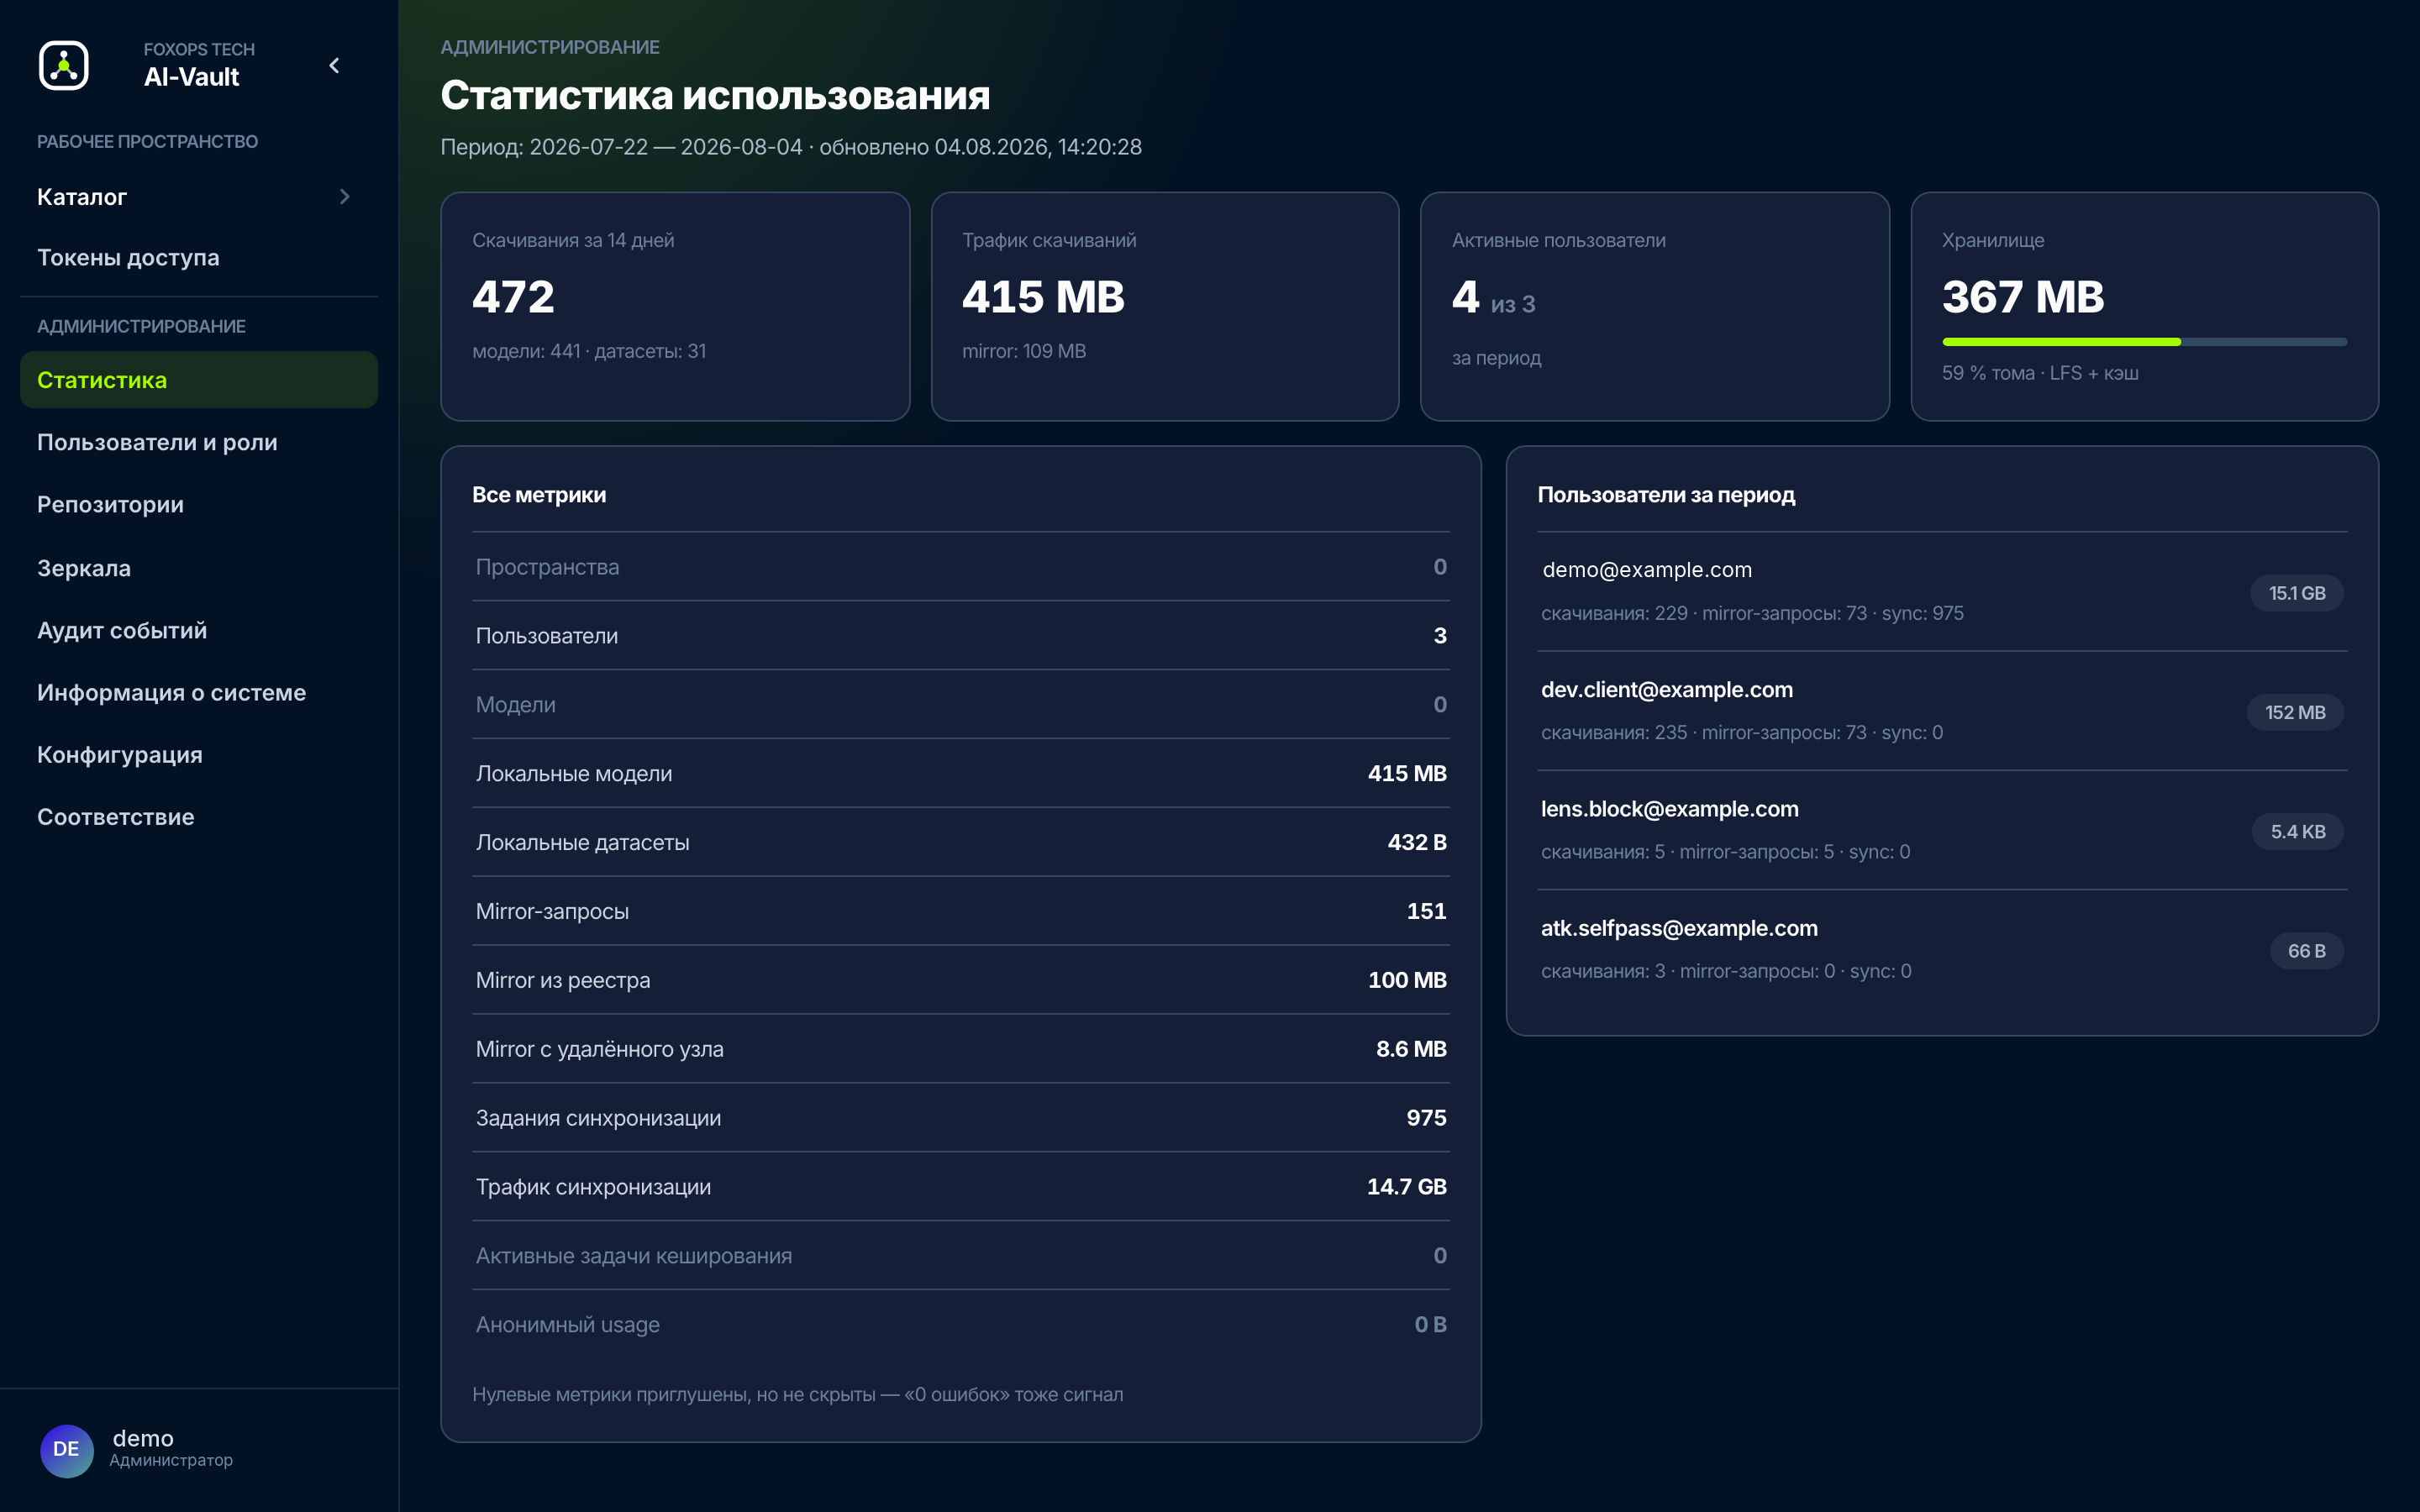
Вход сотрудников под рабочей учетной записью через LDAP или OIDC - отдельный модуль. Журнал событий с фильтрами и выгрузкой - тоже отдельный модуль.
10. FAQ
Нужен ли доступ в интернет?
Нет. В режиме зеркала нужные артефакты заранее копируются внутрь контура, после чего установка работает автономно.
Придется ли менять пайплайны команд?
Нет. Реестр говорит на протоколе Hugging Face - меняется значение HF_ENDPOINT и токен, код остается прежним.
Обучает ли AI-Vault модели?
Нет. Обучение и запуск идут на вашей ML-платформе. Реестр отвечает за хранение, версии, доступ и раздачу.
Как зафиксировать версию модели в инференсе?
Флагом --revision у vLLM или параметром revision в вызовах huggingface_hub. Принимается имя ветки, тег или идентификатор коммита.
Как вернуть предыдущую версию?
В карточке репозитория, вкладка «История коммитов» → «Откатить». Прежние версии остаются в истории.
Нужна помощь с внедрением?
Покажем установку на вашем сценарии и поможем перенести модели.
Запросить демо